Rodar modelos de inteligência artificial diretamente no próprio PC deixou de ser uma curiosidade experimental para se tornar algo real. Seja para garantir privacidade absoluta dos seus dados, eliminar custos recorrentes de assinaturas em nuvem ou evitar limites de uso, montar uma máquina dedicada à IA local em 2026 exige uma abordagem completamente diferente da montagem de um PC gamer, por exemplo.
Enquanto nos jogos o foco está em altas taxas de quadros, na computação de IA local o que manda é a capacidade e largura de banda da memória, especialmente da memória de vídeo. Detalhamos aqui a anatomia de um PC otimizado para inferência local, dividido em componentes essenciais e sugestões de configurações para diferentes orçamentos.
Placa de vídeo
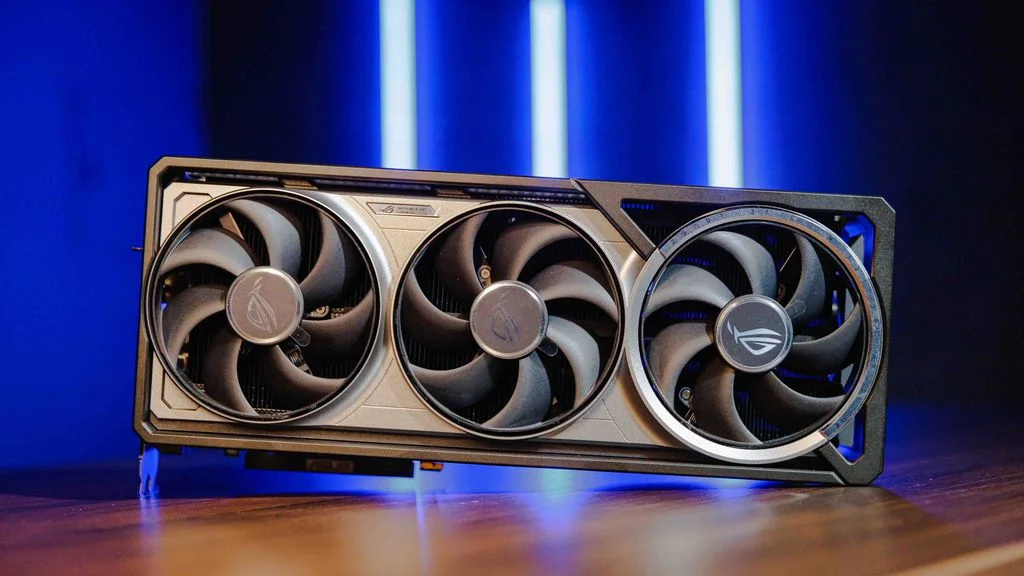
Na IA local, a placa de vídeo é responsável pela maior parte do desempenho. Os modelos de linguagem (como Llama, Qwen e DeepSeek) e geradores de imagem precisam ser carregados inteiramente na VRAM da GPU para operar em velocidade aceitável. Se o modelo exceder a VRAM disponível, ele transborda para a memória RAM do sistema, derrubando a geração de dezenas de tokens por segundo para uma lentidão longe do ideal.
Por isso, a regra de ouro desse segmento é clara: mais VRAM sempre vence uma arquitetura ligeiramente mais rápida com pouca memória. Uma placa de 16 GB ou 24 GB rodará modelos maiores e mais inteligentes do que uma placa de 12 GB, mesmo que esta última tenha mais núcleos de processamento.